Dans la Partie 1 de cette série, j’ai posé le décor du marché PMU, avec le pari mutuel, les acteurs, les masses en ligne / hors ligne, la formation des cotes, et l’écart entre cote de référence et cote finale. Je sais désormais contre qui et dans quel pool je joue. Il reste la question qui compte vraiment pour un particulier. Est-ce que ça rapporte ?
Dans cet article, faisant partie de la même série, je me restreins volontairement. Pas de tour du calendrier sur toutes les disciplines. L’objectif est de définir une baseline honnête, puis d’appliquer l’approche la plus proche possible de Bill Benter (1994), elle-même bâtie sur le logit multinomial de Bolton et Chapman (1986), avant de tester une variante LambdaRank (LightGBM) à protocole égal.
Concrètement, je travaille uniquement sur le plat, la discipline utilisée par Benter à Hong Kong. La première expérimentation consiste à miser en simple placé sur le cheval à la cote finale la plus faible. Ensuite, j’entraîne un modèle fondamental type Benter, puis un LambdaRank, avec un jeu de variables issu à la fois de la littérature et d’échanges avec un ancien jockey de mon entourage, sans prétendre à un feature engineering interminable.
Dans une première partie, je fixe le Protocol (plat, données, cadre de mise, synthèse, évaluation walk-forward). Dans une deuxième partie, je présente la baseline puis ses fondamentaux (Harville, reconstruction). Dans une troisième partie, je présente Bill Benter (objectif et papiers, fondamentaux dont le discount placé et Kelly, variables). Dans une quatrième partie, je déroule les résultats (baseline Harville pur / discounté, Benter, LambdaRank). Je conclus en préparant la suite.
Sommaire
1. Protocol
A. Plat uniquement
Bill Benter a industrialisé le handicapping sur les courses de plat à Hong Kong. C’est un terrain où l’information fondamentale (poids, corde, historique, niveau de course) se lit relativement proprement, sans le bruit d’événement massif des obstacles ni les disqualifications d’allure du trot.
Au trot (attelé ou monté), un cheval peut « casser ». Il galope alors au lieu de trotter, et peut être disqualifié. Ce n’est pas un simple écart de performance. C’est un aléa réglementaire qui casse la continuité entre « potentiel » et « résultat classé ». Pour une première expérimentation, ce bruit supplémentaire rend plus difficile de savoir si l’échec vient du modèle, du rake, ou de la nature même de la discipline. Je mets donc le trot et les obstacles de côté pour l’instant, et je me concentre sur le plat.
B. Données
Les données proviennent de l’API publique PMU / Turfinfo (programme, partants, rapports, arrivées). La collecte s’est déroulée sur plusieurs semaines, avec des appels répétés pour reconstituer l’historique des courses, des partants et des masses, jusqu’aux rapports finaux.
Sur le plat, je dispose d’un historique long, de l’ordre de 2013 à 2026, soit plusieurs dizaines de milliers de courses une fois les partants agrégés. Les masses et rapports en ligne et hors ligne coexistent dans les données, et sont lus séparément lorsque c’est possible.
Deux points importent pour la suite. Premier point, la cote finale simple gagnant est en général disponible pour une large part du plateau. Second point, la cote finale simple placé n’est pas toujours accessible pour tous les chevaux dans les anciennes données. Très souvent, seuls les 2 ou 3 chevaux qui ont effectivement touché un dividende placé apparaissent dans les rapports. Ce n’est pas une cotation pré-course du champ entier. C’est un extrait de règlement post-course. D’où la nécessité, pour décider ex ante, de reconstruire une cote placé complète à partir du simple gagnant.
Sur le prix de décision, je travaille explicitement avec les rapports finaux (ou leur reconstruction Harville), pas avec une cote figée longtemps avant le départ. C’est un biais d’exécution. En live, la cote obtenue peut différer de la cote finale. Je l’accepte volontairement pour mesurer un plafond. En online, ce biais est en partie atténuable. Un bot peut déposer le ticket quelques secondes avant la clôture via automatisation de navigateur (Playwright, Selenium). En offline (réseau / point de vente), ce rattrapage de dernière seconde n’existe pas. Le biais « décision au rapport final » y est clairement plus fort, et les résultats offline doivent se lire avec cette réserve.
C. Cadre de l’expérimentation
Le cadre de mise reste volontairement simple. Sur chaque ticket retenu, je joue une mise plate, c’est-à-dire le montant minimum autorisé par le PMU pour le type de pari et le canal concernés, la mise de base du ticket, inchangée d’une course à l’autre. Ce minimum varie selon la formule (simple gagnant, simple placé, couplé, etc.) et selon que le pari est online ou offline. Pour le simple placé, le montant le plus courant dans nos données est 1 € en ligne et 1,50 € hors ligne. Pas de montée de mise après une série de gains, pas de « chase » après une série de pertes. L’idée est d’isoler la qualité de la sélection (et des probabilités) sans confondre le résultat avec un effet de sizing agressif.
Il existe une alternative classique, le critère de Kelly, qui dimensionne la mise en fonction de la bankroll, de la cote et de la probabilité estimée. C’est le levier naturel dès qu’un modèle produit une vraie espérance, je le présente dans la section Bill Benter. Pour les résultats de cette Partie 2, je reste toutefois en mise plate, afin de comparer baseline et Benter à friction de sizing égale.
D. Synthèse
La baseline répond à une question simple. Sans aucune expertise équestre, si je suis bêtement le marché en simple placé, que reste-t-il après rake ?
Le protocole est volontairement optimiste sur l’exécution, afin de mesurer un plafond. Comme visible sur le Tableau 1, je le compare côte à côte avec l’approche Bill Benter développée plus loin. Les lignes communes restent figées ; seules changent la source des probabilités, la sélection et le correctif placé \(\gamma\).
| Paramètre | Baseline | Bill Benter / LambdaRank |
|---|---|---|
| Discipline | Plat | Plat |
| Pari | Simple placé | Simple placé |
| Canaux | Online et offline, lus séparément | Online et offline, lus séparément |
| Prix de décision | Rapport final (ou reconstruction Harville) | Rapport final (ou reconstruction Harville) |
| Mise (résultats article) | Plate (min. PMU : ~1 € online / ~1,50 € offline en simple placé) | Plate (idem) |
| Probabilités | Implicites du marché (simple gagnant) | Modèle fondamental + combinaison marché \((\alpha,\beta)\) |
| Translation gagnant vers placé | Harville pur (\(\gamma = 1\)), ou variante \(\gamma \approx 0{,}81\) | Harville avec discount Benter (\(\gamma \approx 0{,}81\)) |
| Sélection | Cheval à la cote placé la plus faible | Chevaux avec edge modèle vs cote (seuil d’espérance) |
| Règlement P&L | Rapports placé officiels quand disponibles | Rapports placé officiels quand disponibles |
Tableau 1 : Paramètres du protocole, baseline vs Bill Benter / LambdaRank.
Si la baseline, qui exploite déjà l’information contenue dans la cote, perd de l’argent, un modèle plus riche devra montrer un gain incrémental clair (section Résultats). Sinon, je changerai d’angle (Partie 3).
Dans cette Partie 2, je teste trois choses.
- Une baseline, qui consiste à miser 1 ticket en simple placé sur le cheval à la cote placé (finale / reconstruite) la plus faible (Harville pur, puis Harville discounté).
- Un modèle Bill Benter, avec probabilités fondamentales (logit) et combinaison avec le marché, sur le même univers plat.
- Un LambdaRank (LightGBM), dans la même coquille Benter (marché, \(\gamma\), \(EV_{\min}\)), mais avec des scores fondamentaux via learning-to-rank.
E. Évaluation (walk-forward)
L’évaluation n’est pas un unique split aléatoire train/test. Les courses sont ordonnées dans le temps. J’utilise une validation walk-forward à \(K = 5\) folds, avec environ 20 % de test sur la fenêtre la plus récente de chaque fold, comme visible sur la Figure 1.
Sur chaque fold :
- J’entraîne le modèle fondamental sur le passé du fold ;
- J’estime éventuellement \((\alpha, \beta)\) d’agrégation Benter sur ce passé ;
- J’applique la stratégie sur la période test du fold ;
- J’agrège les courbes de PnL / bankroll (simple gagnant et simple placé, online / offline lorsque disponibles).
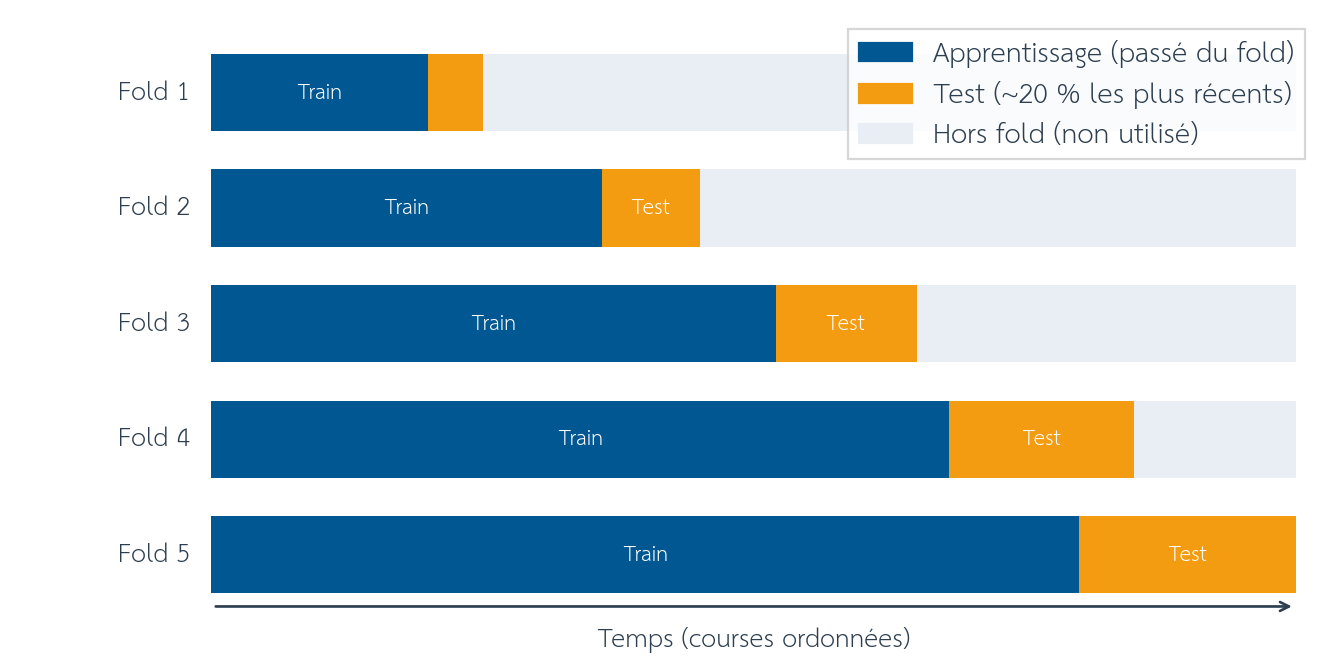
Figure 1 : Validation walk-forward à 5 folds. En bleu : période d’apprentissage (passé du fold, fenêtre croissante). En orange : période de test (~20 % les plus récents). Le modèle ne voit jamais le futur.
Les métriques utiles pour l’article sont pragmatiques. J’utilise le ROT (gain net / volume misé), la bankroll cumulée, le taux de tickets gagnants, le volume de paris dans le temps, et une comparaison avec un modèle de référence naïf (« baseline naïve ») à univers égal.
2. Baseline
A. Présentation
L’objectif de la baseline est de mesurer un plafond « marché seul ». Sans aucune expertise équestre, je suis le favori à se placer, c’est-à-dire le cheval à la cote placé la plus faible (finale ou reconstruite). Si même cette stratégie, qui exploite déjà l’information contenue dans les masses, ne survit pas au rake, la barre est haute pour tout modèle plus riche. C’est aussi le repère contre lequel juger l’apport incrémental de Bill Benter, à univers et frictions égaux.
B. Fondamentaux
i. Principe de Harville
a. Présentation
Pourquoi reconstruire ? Lors de la collecte des données historiques, les courses les plus récentes exposent souvent une cote finale (ou un rapport probable final) en simple placé pour tous les chevaux du plateau. Ce n’est pas le cas sur l’historique plus ancien. La map placé n’y retient fréquemment que les 2 ou 3 chevaux qui ont touché un dividende, pas une cotation pré-course du champ entier. Pour décider ex ante sur toute la période, il faut donc une règle qui reconstitue une cote placé complète à partir du simple gagnant, d’où Harville.
Je dispose souvent d’une bonne estimation des probabilités de victoire \(p_i = P(i\text{ gagne})\), par exemple via les cotes mutuelles simple gagnant. En revanche, le simple placé demande autre chose, à savoir la probabilité que \(i\) finisse dans les places payées (en général top 2 ou top 3).
Harville (1973) propose une hypothèse simple, presque brutale. Une fois le gagnant connu, les chances relatives des chevaux restants pour la place suivante restent proportionnelles à leurs \(p_i\) de victoire d’origine. Autrement dit, si le cheval \(j\) a déjà gagné, soit \(P(i\text{ est 2}^{\mathrm{e}} \mid j\text{ est 1}^{\mathrm{er}})\) la probabilité que le cheval \(i\) finisse deuxième. Elle est représentée dans la formule (1).
\[ P(i\text{ est 2}^{\mathrm{e}} \mid j\text{ est 1}^{\mathrm{er}}) = \frac{p_i}{1 – p_j} \quad (i \neq j). \tag{1} \]
En sommant sur tous les vainqueurs possibles, j’obtiens \(P(i\text{ est 2}^{\mathrm{e}})\). J’itère de la même façon pour la 3ᵉ place. Soit \(P_i^{\mathrm{place}}\) la probabilité que le cheval \(i\) finisse dans les trois places payées. Elle est représentée dans la formule (2).
\[ P_i^{\mathrm{place}} = P(i\text{ 1}^{\mathrm{er}}) + P(i\text{ 2}^{\mathrm{e}}) + P(i\text{ 3}^{\mathrm{e}}). \tag{2} \]
L’intérêt est immédiat. À partir d’un seul vecteur de probabilités de victoire, je fabrique des probabilités de place pour tout le plateau, sans avoir besoin d’un historique de dividendes placé complets. La limite l’est aussi. L’hypothèse d’indépendance conditionnelle est fausse en pratique. Empiriquement, Harville a tendance à surestimer les chances de place des favoris et à sous-estimer celles des outsiders sur les rangs 2 et 3. C’est précisément ce biais que Benter corrigera plus loin avec un facteur \(\gamma\).
b. Exemple
Sur une course réelle de plat (2014-05-16, R2C4), j’observe 12 chevaux cotés en simple gagnant, mais seulement 3 chevaux avec un dividende placé publié. Après reconstruction Harville, j’obtiens une cote placé pour tout le plateau. Comme visible sur le Tableau 3, les trois dividendes observés restent dans le même ordre de grandeur que l’estimation, sans coller parfaitement, ce qui est attendu. Harville est une approximation, et le take-out / la troncature PMU ajoutent du bruit.
| N° | Cote SG | \(P^{\mathrm{win}}\) | \(P^{\mathrm{place}}\) (Harville) | Cote placé estimée | Cote placé observée |
|---|---|---|---|---|---|
| 3 | 4,8 | 0,20 | 0,54 | 1,33 | n.d. |
| 1 | 6,5 | 0,15 | 0,42 | 1,70 | 2,0 |
| 5 | 6,7 | 0,14 | 0,41 | 1,74 | 2,4 |
| 15 | 9,2 | 0,10 | 0,31 | 2,30 | n.d. |
| 7 | 11,0 | 0,09 | 0,27 | 2,70 | 3,3 |
| 4 | 14,0 | 0,07 | 0,21 | 3,37 | n.d. |
| … | … | … | … | … | … |
Tableau 3 : Exemple Harville, reconstruction des cotes placé (extrait ; course 2014-05-16, R2C4).
ii. Reconstruction des cotes placé manquantes
La baseline lit d’abord les probabilités implicites du simple gagnant. Elle n’utilise pas le rapport placé partiel pour décider. Elle estime les cotes placé via Harville à partir du simple gagnant.
La baseline pure utilise un Harville sans discount. Une variante reprend le même protocole avec le facteur de Benter \(\gamma \approx 0{,}81\) ; j’y reviendrai dans la section Bill Benter, une fois le principe de Benter posé.
Schématiquement, pour la baseline Harville pure :
- Soit \(C_i^{\mathrm{SG}}\) la cote finale simple gagnant du cheval \(i\).
- Soit \(p_i = P_i^{\mathrm{win}}\) la probabilité de victoire implicite du cheval \(i\), obtenue en normalisant les inverses de cotes. Elle est représentée dans la formule (3).
\[ p_i = P_i^{\mathrm{win}} = \frac{1/C_i^{\mathrm{SG}}}{\sum_j 1/C_j^{\mathrm{SG}}}. \tag{3} \]
- Je calcule \(P_i^{\mathrm{place}}\) par les formules de Harville ci-dessus (2 ou 3 places selon le nombre de partants).
- Soit \(t_{\mathrm{place}}\) le take-out du pool placé (ordre de grandeur ~28 %), et \(C_i^{\mathrm{place}}\) la cote placée nette approximative du cheval \(i\). Cette cote est représentée dans la formule (4).
\[ C_i^{\mathrm{place}} \approx \frac{1 – t_{\mathrm{place}}}{P_i^{\mathrm{place}}}. \tag{4} \]
Les rapports placé officiels restent utilisés, quand ils existent, pour le règlement du P&L. La décision, elle, ne doit pas s’appuyer sur une liste qui ne cote que les gagnants du dividende.
3. Bill Benter
A. Présentation
L’objectif du modèle Bill Benter est de mesurer un plafond « fondamental + marché ». J’estime des probabilités de victoire à partir de variables pré-course, je les combine avec l’information déjà présente dans les cotes, puis je traduis le tout en simple placé pour décider où (et si) miser. Là où la baseline ne fait que suivre le favori placé, Benter cherche un edge, c’est-à-dire un cheval dont la probabilité combinée dépasse ce que le pool implicite laisse entendre, à univers et frictions égaux.
La construction s’appuie sur trois papiers de recherche. Bolton et Chapman (1986) introduisent le logit multinomial pour le handicapping, avec un score latent par cheval, normalisé en probabilités de victoire sur le plateau. Bill Benter (1994) reprend cette famille, l’industrialise sur le plat à Hong Kong, et y ajoute la pièce décisive, la combinaison \((\alpha,\beta)\) entre modèle fondamental et marché, ainsi que le correctif placé \(\gamma\) sur la translation gagnant vers placé. Harville (1973) fournit enfin la mécanique qui transforme un vecteur de probabilités de victoire en probabilités de place, reprise ici avec le discount de Benter.
Par rapport à la baseline, le cadre commun du Tableau 1 reste figé (plat, simple placé, canaux, rapport final, mise plate pour les résultats de l’article, règlements officiels). Ce qui change, ce sont trois points.
- L’origine des probabilités, modèle fondamental + combinaison marché \((\alpha,\beta)\), au lieu des seules cotes.
- La règle de sélection, je ne suis plus le favori de cote, je ne mise que lorsqu’il y a un edge (espérance au-dessus d’un seuil).
- La translation gagnant vers placé, Harville avec discount \(\gamma \approx 0{,}81\).
Les variables utilisées sont détaillées en 3.C.
B. Fondamentaux
i. Du Harville au discount de Benter (simulation placé)
a. Présentation
Le cœur du papier de Benter est formulé sur la victoire. Dès que je veux parier (ou évaluer) le simple placé, il faut redescendre des \(P_i^{\mathrm{win}}\) vers des \(P_i^{\mathrm{place}}\). Je reprends alors Harville… mais Benter documente le biais rappelé plus haut. Avec les \(p_i\) bruts, les favoris sont trop « placés » et les outsiders pas assez.
Sa correction opérationnelle est un discount sur les probabilités avant d’appliquer les formules de rang 2 et 3. Soit \(\tilde{p}_i\) la probabilité de victoire discountée du cheval \(i\), et \(\gamma\) le facteur de discount, avec \(\gamma < 1\) (ici \(\gamma \approx 0{,}81\)). Je remplace \(p_i\) par la transformation représentée dans la formule (5).
\[ \tilde{p}_i \propto p_i^{\gamma}. \tag{5} \]
Comme \(\gamma < 1\), l’opération aplatit la distribution. Elle retire un peu de masse aux gros favoris et en redonne aux outsiders, précisément là où Harville se trompe le plus sur les places. Puis je calcule \(P(\text{2}^{\mathrm{e}})\) et \(P(\text{3}^{\mathrm{e}})\) à la Harville, mais avec les \(\tilde{p}_i\).
b. Exemple
Reprenons la même course (2014-05-16, R2C4). Je calcule d’abord les \(P^{\mathrm{place}}\) Harville purs (\(\gamma = 1\)), puis les mêmes probabilités après discount \(\gamma = 0{,}81\). Comme visible sur le Tableau 4, le favori (n°3) perd environ 5 points de probabilité placé ; les outsiders en gagnent. C’est exactement le sens du correctif. Le gros favori reçoit moins de place « gratuite », et le reste du plateau un peu plus de masse.
| N° | \(P^{\mathrm{win}}\) | \(P^{\mathrm{place}}\) (\(\gamma=1\)) | \(P^{\mathrm{place}}\) (\(\gamma=0{,}81\)) | Écart |
|---|---|---|---|---|
| 3 | 0,20 | 0,53 | 0,47 | −0,05 |
| 1 | 0,15 | 0,42 | 0,39 | −0,03 |
| 5 | 0,14 | 0,41 | 0,38 | −0,03 |
| 7 | 0,09 | 0,27 | 0,27 | ≈0 |
| 4 | 0,07 | 0,22 | 0,23 | +0,01 |
| 8 | 0,05 | 0,16 | 0,18 | +0,02 |
| 9 | 0,01 | 0,03 | 0,05 | +0,02 |
Tableau 4 : Effet du discount Benter \(\gamma \approx 0{,}81\) sur les probabilités placé (même course que le Tableau 3).
ii. Modèle fondamental (logit / softmax)
a. Présentation
L’idée centrale n’est pas de « deviner le gagnant » contre un bookmaker. C’est d’estimer, pour chaque cheval \(i\) d’une course à \(n\) partants, une probabilité de victoire cohérente \(\sum_i P_i = 1\).
Bolton et Chapman (1986) proposent un logit multinomial. Benter (1994) reprend cette famille de modèles et la pousse en production. Concrètement, j’estime une régression logistique fondamentale sur des variables pré-course. Chaque cheval \(i\) d’une course à \(n\) partants reçoit un score latent \(s_i\) (combinaison linéaire des variables, notamment le poids relatif, la forme récente, la corde, le niveau de course, etc.). Soit \(P_i^{\mathrm{fond}}\) la probabilité de victoire du modèle fondamental pour le cheval \(i\). Ces scores sont ensuite normalisés course par course via un softmax, représenté dans la formule (6).
\[ P_i^{\mathrm{fond}} = \frac{e^{s_i}}{\sum_{j=1}^{n} e^{s_j}}. \tag{6} \]
Le cheval au plus haut score reçoit la plus forte probabilité, mais le plateau reste une distribution, pas un singleton. La somme des \(P_i^{\mathrm{fond}}\) vaut toujours 1.
b. Exemple
Reprenons encore la course (2014-05-16, R2C4). Pour illustrer le passage scores → probabilités, je me donne des scores latents fictifs mais ordonnés comme un handicapeur pourrait les produire, puis j’applique la formule (6). Comme visible sur le Tableau 5, le favori fondamental (n°3) sort à \(P^{\mathrm{fond}} \approx 0{,}24\), un cran au-dessus de la probabilité implicite marché du Tableau 3 (\(0{,}20\)) ; d’autres chevaux sont légèrement « remontés » ou « rabattus ». L’essentiel à retenir est le suivant. Le modèle ne désigne pas un gagnant unique, il répartit la masse de probabilité sur tout le plateau.
| N° | Score \(s_i\) | \(e^{s_i}\) | \(P^{\mathrm{fond}}\) | \(P^{\mathrm{mkt}}\) (rappel) |
|---|---|---|---|---|
| 3 | 1,40 | 4,06 | 0,24 | 0,20 |
| 1 | 1,00 | 2,72 | 0,16 | 0,15 |
| 5 | 0,90 | 2,46 | 0,15 | 0,14 |
| 15 | 0,40 | 1,49 | 0,09 | 0,10 |
| 7 | 0,20 | 1,22 | 0,07 | 0,09 |
| 4 | −0,10 | 0,90 | 0,05 | 0,07 |
| … | … | … | … | … |
Tableau 5 : Exemple logit / softmax, scores latents → probabilités fondamentales (extrait ; même course que les Tableaux 3 et 4). Les \(P^{\mathrm{mkt}}\) rappellent le Tableau 3.
iii. Combinaison avec le marché (α, β)
L’apport décisif de Benter n’est pas seulement le logit. C’est la combinaison entre le modèle fondamental et la « sagesse des foules » déjà présente dans les cotes.
La logique est intuitive. Un modèle, même bien calibré, ne voit que ce qui est dans ses variables. Le pool mutuel, lui, agrège des milliers de mises, venues d’handicapeurs sérieux, d’habitués de l’hippodrome et d’infos locales (état de la piste vu du paddock, cheval qui « ne plaît pas » le matin, rumeur de forme). La sagesse des foules stipule que la foule a le plus souvent raison, non parce que chaque parieur est expert, mais parce que l’agrégat capture des signaux qu’un observateur isolé (ou un modèle distant) n’a pas. Il peut y avoir, sur place, des gens qui détiennent une information que ni vous ni le modèle n’avez. Ignorer la cote, c’est jeter cette information. L’inverse, ne faire que suivre la cote, est la baseline. Benter cherche le milieu, en gardant le fondamental et la foule.
Je note \(P_i^{\mathrm{mkt}}\) la probabilité implicite du marché (dérivée des rapports, après normalisation / facteur de marge). Benter cherche des coefficients \(\alpha\) (poids du modèle) et \(\beta\) (poids du marché) tels que la probabilité combinée finale \(P_i\) améliore la vraisemblance hors échantillon. Cette probabilité est représentée dans la formule (7).
\[ P_i \propto \bigl(P_i^{\mathrm{fond}}\bigr)^{\alpha} \bigl(P_i^{\mathrm{mkt}}\bigr)^{\beta} \tag{7} \]
Cette étape d’agrégation est optimisée sur chaque fold.
Si \(\alpha\) est élevé et \(\beta\) faible, je fais davantage confiance au fondamental. Si c’est l’inverse, le marché domine. En pratique, les deux apportent de l’information, et c’est précisément pour cela que la baseline « marché seul » doit être battue franchement pour justifier la complexité.
iv. Critère de Kelly
a. Présentation
Dès que je dispose d’une probabilité estimée \(p\) et d’une cote nette décimale \(C\), la question n’est plus seulement « qui jouer », mais combien miser. Le critère de Kelly répond en maximisant le taux de croissance logarithmique de la bankroll. Soit \(f^{\star}\) la fraction de Kelly, c’est-à-dire la fraction optimale de bankroll à miser. Elle est représentée dans la formule (8).
\[ f^{\star} = \frac{p\,C – 1}{C – 1}. \tag{8} \]
Si \(p\,C < 1\) (pas d’edge), alors \(f^{\star} \le 0\) et je ne mise pas. Si l’edge est fort, \(f^{\star}\) monte, jusqu’à se heurter à la variance et à la liquidité du pool.
En pratique, j’utilise souvent une fraction de Kelly (par exemple le demi-Kelly, avec \(f = \tfrac{1}{2} f^{\star}\)) pour amortir l’erreur d’estimation de \(p\) et les chocs de bankroll. C’est le sizing naturel du pipeline Benter dès que les probabilités sont jugées assez fiables.
Pour les résultats de cette Partie 2, je reste toutefois en mise plate (cf. 1.C). Ainsi, j’isole l’apport du modèle sans confondre avec un effet de sizing. Kelly reste le levier à activer ensuite, une fois l’edge empirique établi.
b. Exemple
Pour voir concrètement le signe de \(f^{\star}\), je fixe une cote \(C = 4{,}0\) et je fais varier \(p\). Comme visible sur le Tableau 6, dès que \(p\,C < 1\), Kelly refuse le ticket ; dès qu’il y a un edge, la fraction croît avec l’écart \(p\,C - 1\). Le demi-Kelly divise simplement cette fraction par deux. Ainsi, la décision d’entrée reste la même mais la mise est plus prudente.
| Cas | \(p\) | \(C\) | \(p\,C\) | \(f^{\star}\) | Demi-Kelly | Décision |
|---|---|---|---|---|---|---|
| Pas d’edge | 0,20 | 4,0 | 0,80 | ≤ 0 | — | ne pas miser |
| Edge nul | 0,25 | 4,0 | 1,00 | 0 % | 0 % | indifférent |
| Edge modéré | 0,30 | 4,0 | 1,20 | 6,7 % | 3,3 % | miser (fraction) |
| Edge plus fort | 0,40 | 3,0 | 1,20 | 10,0 % | 5,0 % | miser (fraction) |
Tableau 6 : Exemple Kelly, fraction de bankroll selon \(p\) et \(C\) (formule (8)). « — » : fraction non définie / non positive.
C. Variables retenues pour le plat
i. Synthèse
Je n’ai pas fait un marathon de feature engineering. Une partie du jeu vient directement de Bill Benter (1994), notamment la forme, le poids, la corde, la classe, le couple jockey / entraîneur, le repos, les préférences de distance et de piste. Une autre vient de discussions avec un ancien jockey de plat de mon entourage, sur une lecture plus fine du poids relatif, le couple jockey×cheval, la méfiance envers certaines courses à réclamer, et des indices de performance plus proches de la façon dont un handicapeur « lit » une course. Beaucoup de variables sont transparentes (positions récentes, jours depuis la dernière course, rentrée, maiden, réclamer…). Les sous-parties suivantes ne reprennent que celles dont la construction repose sur une formule ou une hypothèse un peu plus riche, d’abord dans l’esprit du papier (ii. Variables originales), puis celles ajoutées après ces échanges (iii. Variables ajoutées).
Comme visible sur le Tableau 2, les variables retenues sont regroupées par catégories et sous-catégories. Toutes sont calculées pré-course (pas de fuite du type écart au gagnant du jour). Elles ne remplacent pas un travail handicapeur humain. Elles donnent une base mesurable pour voir si, après rake, il reste un edge.
| Catégorie | Sous-catégorie | Exemples | Intuition |
|---|---|---|---|
| Cheval | forme & historique | places récentes, forme relative, délai depuis la dernière course, rentrée, incident récent, nombre de courses passées | Ce que le cheval a fait récemment, et s’il revient de loin |
| niveau & gains | force des adversaires passés, classe de course, baisse/hausse de niveau, gains totaux, maiden, réclamer | Contre qui il a couru, et à quel niveau il descend / monte | |
| indices de perf | part d’adversaires battus, indices de performance, performance projetée, coefficient de niveau | Synthèses type handicapeur (adversaires battus × niveau × poids) | |
| Poids | n.d. | écart au poids moyen du plateau, poids relatif, poids portés par le passé, stabilité du poids, changement de conditions | Fardeau du jour vs plateau et vs historique |
| Piste & conditions | corde, terrain, surface | impact de la corde, biais de piste, affinité terrain/surface, préférence d’hippodrome, aptitude à la distance | Géométrie de piste et aptitudes |
| Acteurs | jockey | taux de victoire et de place du jockey | Skill jockey sur longue période |
| entraîneur | taux de victoire et de place de l’entraîneur | Skill entraîneur (souvent moins décisif que le jockey selon le retour terrain) | |
| jockey × cheval | taux de victoire et de place du couple | Affinité de couple | |
| Course du jour | n.d. | nombre de partants, force du plateau, cheval supplémenté, distance | Contexte immédiat du plateau |
Tableau 2 : Variables plat utilisées pour l’approche Benter de l’article, par catégorie et sous-catégorie.
ii. Variables originales
a. Compensation de corde (résidu)
La corde ne se lit pas « 1 = bien, 12 = mal » en absolu. Sur une piste et une distance données, certaines barrières sont structurellement plus dures. Soit \(r\) le résidu de corde pour une course passée du cheval. C’est l’écart entre la position attendue compte tenu de l’hippodrome, de la distance et de la corde, et la position réelle. Il est représenté dans la formule (9).
\[ r = \mathbb{E}[\text{position} \mid \text{hippodrome}, \text{distance}, \text{corde}] – \text{position réelle}. \tag{9} \]
Un résidu positif signifie que le cheval a fait mieux que ce que la barrière laissait attendre. La variable du jour est la moyenne des derniers résidus passés (hors course courante). C’est une compensation de draw, pas une cote.
b. Préférence de distance
Un cheval peut exceller sur le mile et s’effondrer sur 2 400 m. Je compare chaque arrivée passée à la moyenne d’arrivées du cheval, puis je pondère ces écarts par la similarité de distance avec la course du jour (poids qui décroît quand l’écart de mètres augmente). Le score est ensuite standardisé et borné. Autrement dit, je ne garde que la forme passée pertinente pour la distance d’aujourd’hui.
c. Taux jockey (et entraîneur) lissés
Avec peu de montes, un taux brut de 100 % ou 0 % ne veut rien dire. Soit \(\hat{p}\) le taux lissé, \(s\) le nombre de succès (victoires ou places), \(n\) le nombre de montes, \(\pi\) un prior raisonnable (de l’ordre de 10 % en victoire, 25 % en place) et \(\alpha\) la force du prior. J’utilise un lissage de Laplace, représenté dans la formule (10).
\[ \hat{p} = \frac{s + \alpha\,\pi}{n + \alpha}. \tag{10} \]
Même logique pour l’entraîneur. Cela évite de sur-réagir aux petits échantillons.
d. Poids relatif au plateau
En plat, le poids désigne la charge que le cheval doit porter le jour de la course. Elle regroupe le jockey, la selle et, le cas échéant, des plombs ajoutés dans le tapis pour atteindre le kilo prescrit. Ce n’est pas le poids vif du cheval. C’est une contrainte de charge sur la distance.
Qui fixe ce kilo dépend du type de course. Dans un handicap, ce sont les handicapeurs de France Galop qui allouent les poids à partir d’une valeur officielle (rating) de chaque cheval. L’idée est d’égaliser les chances. Un cheval mieux coté part plus chargé. Dans une course à conditions (maiden, conditions d’âge ou de sexe, Listed, Groupes…), le règlement de l’épreuve fixe les poids de référence, avec éventuelles surcharges (pénalités après une victoire récente) ou allègements (âge, sexe). Dans tous les cas, le kilo du jour figure au programme officiel avant le départ.
Le poids porté n’a de sens que contre le lot du jour. Je retiens l’écart (et le ratio) au poids moyen du plateau, ainsi qu’un indicateur de stabilité par rapport aux poids récemment portés. C’est la version opérationnelle de « ce cheval est-il plus ou moins chargé que ses adversaires aujourd’hui ? ».
iii. Variables ajoutées
a. Part d’adversaires battus et indice de performance
Soit \(N\) le nombre de partants, \(P\) la place d’arrivée du cheval, et \(\mathrm{PAB}\) la part d’adversaires battus. Si le cheval termine \(P^{\mathrm{e}}\), le PAB est représenté dans la formule (11).
\[ \mathrm{PAB} = \frac{N – P}{N – 1}. \tag{11} \]
(avec une convention pénalisante s’il n’est pas classé). Un PAB proche de 1 signifie qu’il a battu presque tout le monde ; proche de 0, l’inverse. Soit \(I_{\mathrm{Perf}}\) l’indice de performance, \(C_{\mathrm{niveau}}\) un coefficient de niveau de la course, et \(W_{\mathrm{relatif}}\) le poids relatif au plateau. Je combine ensuite PAB avec le niveau et le poids relatif, comme représenté dans la formule (12).
\[ I_{\mathrm{Perf}} = \mathrm{PAB} \times C_{\mathrm{niveau}} \times W_{\mathrm{relatif}}. \tag{12} \]
Battre 10 chevaux dans un Groupe n’a pas le même sens que battre 10 chevaux à réclamer ; porter plus lourd que la moyenne renforce la note. Je conserve l’historique (moyenne passée) et la dernière sortie, toujours en décalage d’une course pour éviter la fuite.
b. Performance projetée
Soit \(\mathrm{Perf}\) la performance projetée, \(V_{\mathrm{gagnant}}\) la valeur de référence du gagnant, \(W\) et \(W_{\mathrm{gagnant}}\) les poids portés (cheval et gagnant), \(\Delta_{\mathrm{longueurs}}\) la distance perdue en longueurs, \(d\) la distance de la course, et \(K(d)\) un facteur qui traduit combien de kilos « valent » une longueur. L’idée est de ramener une performance passée sur une échelle comparable, en corrigeant le poids et la distance perdue, comme représenté dans la formule (13).
\[ \mathrm{Perf} \approx V_{\mathrm{gagnant}} + (W – W_{\mathrm{gagnant}}) – (\Delta_{\mathrm{longueurs}} \times K(d)). \tag{13} \]
\(K(d)\) est plus élevé sur le sprint, plus faible sur les longues distances. Seules les perfs passées (et leur moyenne) entrent dans le modèle. Je ne recalcule pas la course du jour avec l’arrivée du jour.
c. Aptitude à la corde (gauche / droite)
Certains chevaux sont meilleurs en fonction de l’orientation du virage de la piste. Je compare, sur l’historique, la perf moyenne quand le cheval a couru à gauche et quand il a couru à droite. Soit \(\mu_{\mathrm{g}}\) la moyenne des perfs passées à gauche, \(\mu_{\mathrm{d}}\) la moyenne des perfs passées à droite, et \(\Delta_{\mathrm{apt}}\) l’écart d’aptitude. Il est représenté dans la formule (14).
\[ \Delta_{\mathrm{apt}} = \mu_{\mathrm{g}} – \mu_{\mathrm{d}}. \tag{14} \]
Un \(\Delta_{\mathrm{apt}}\) positif signifie une meilleure perf moyenne à gauche ; un écart négatif, à droite. Je peux alors : – Bonifier rétrospectivement les courses passées courues « à contre-emploi » ; – Pénaliser la projection du jour si la corde actuelle est du mauvais côté.
C’est une lecture de jockey formalisée. La géométrie de piste n’est pas neutre pour tous les profils.
d. Impact géométrique de la corde
Au-delà du résidu Benter, j’ajoute une pénalité plus physique. Soit \(c\) le numéro de corde, \(N\) le nombre de partants, \(d\) la distance en mètres, et \(\tau(d)\) un facteur de tournants. Ce facteur vaut 0 en dessous de 1 000 m (corde large peu coûteuse) et 1 au-delà de 1 600 m (pénalité pleine), avec une montée linéaire entre les deux. La pénalité géométrique \(I_{\mathrm{corde}}\) est représentée dans la formule (15).
\[ I_{\mathrm{corde}} = \frac{c}{N} \times \tau(d). \tag{15} \]
Une valeur élevée signale un désavantage relatif de la stalle compte tenu de la distance. J’y croise aussi un biais de piste historique. Sur un hippodrome et une distance donnés, je découpe les cordes en trois tiers (intérieur, milieu, extérieur) et je compare le taux de victoire du tiers à celui de l’ensemble. Si certains tiers gagnent trop souvent sur cet hippodrome et cette distance, l’indice de biais le met en évidence. L’objectif n’est pas de remplacer le résidu, mais de croiser une lecture statistique (Benter) avec une lecture plus mécanique (largeur de corde, tournants).
e. Couple jockey × cheval
Le taux all-time du jockey ne dit pas s’il « va » avec ce cheval. J’estime un taux de victoire / de place sur le couple. Comme pour le jockey seul (formule (10)), j’applique un lissage de Laplace. Je mélange le taux empirique du duo (succès et montes passés de cette association uniquement) avec un prior raisonnable (de l’ordre de 10 % en victoire, 25 % en place), pour éviter de sur-réagir aux petits échantillons. En première collaboration, l’information est volontairement absente plutôt que remplacée par un prior trompeur.
4. Résultats
A. Baseline
i. Harville pur
Dans tout ce qui suit, le seuil d’espérance \(EV_{\min}\) désigne le filtre de ticket. Je ne mise que si \(\hat{p} \times \text{cote} \ge EV_{\min}\). \(EV_{\min} = 0\) signifie que je parie dès qu’une cote de décision existe. \(EV_{\min} = 1\) est le seuil d’équilibre (espérance nulle avant rake). Sans expertise équestre, je suis le favori placé (cote placé reconstruite la plus faible), mise plate, canaux online / offline séparés.
Estimateur placé = Harville avec \(\gamma = 1\) (pas de discount Benter). Je compare \(EV_{\min} = 0\) (sans filtre d’espérance) et \(EV_{\min} = 1\) (seuil d’équilibre).
La Figure 2 présente le PnL cumulé Harville pur sans filtre d’espérance (\(EV_{\min} = 0\)), online et offline sur le même graphe.
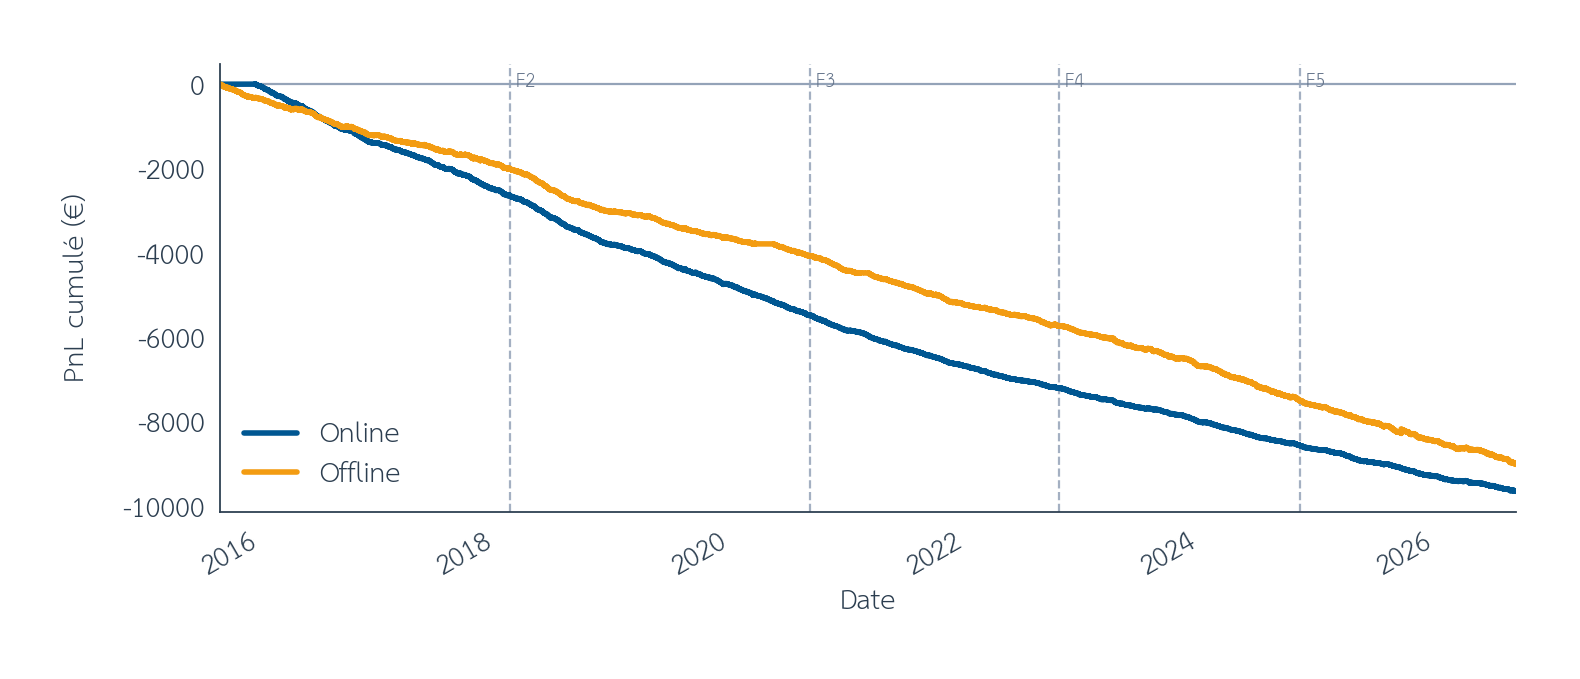
Figure 2 : Harville pur, PnL cumulé sans filtre d’espérance (\(EV_{\min} = 0\)). Online et offline sur le même graphe, entre août 2015 et septembre 2026. Les barres verticales en pointillés marquent les limites des folds walk-forward. Source : pmu.fr.
La Figure 3 montre le même PnL cumulé avec \(EV_{\min} = 1\).
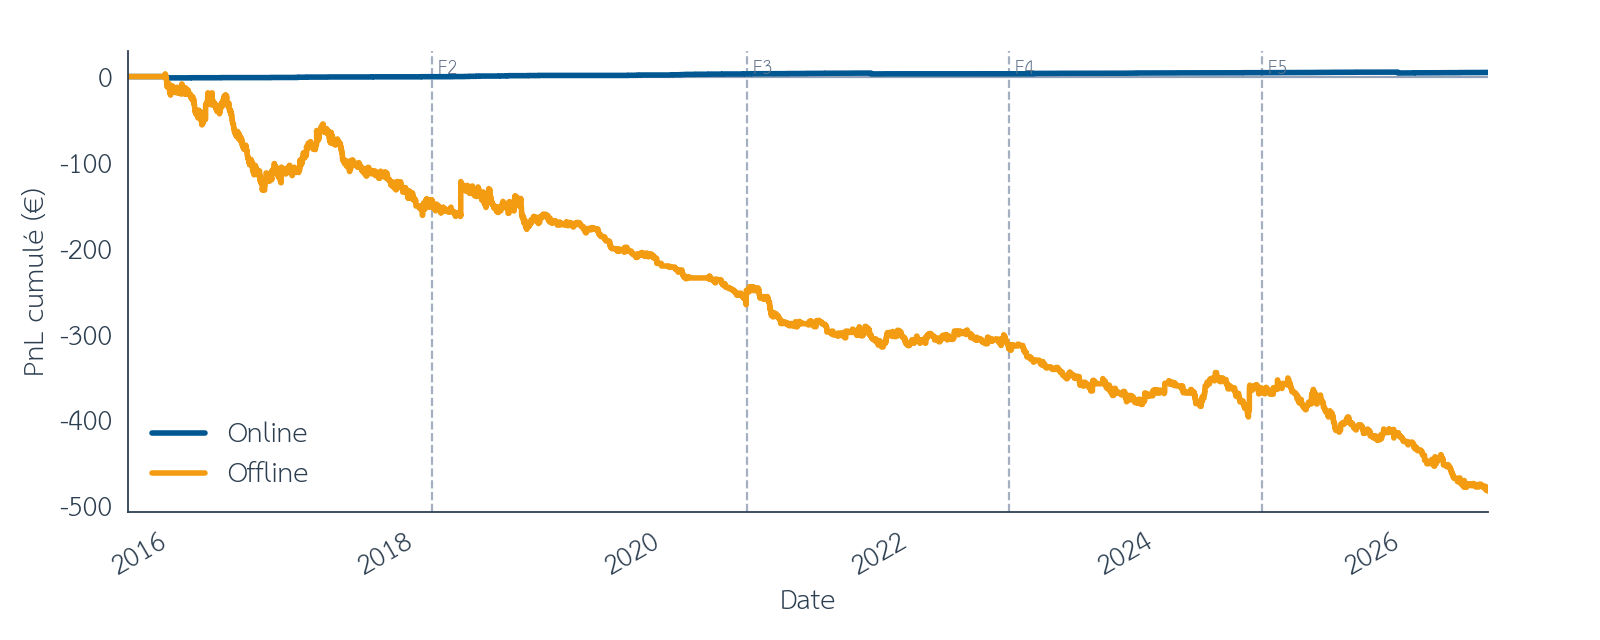
Figure 3 : Harville pur, PnL cumulé avec \(EV_{\min} = 1\). Online et offline sur le même graphe, entre août 2015 et septembre 2026. Les barres verticales en pointillés marquent les limites des folds walk-forward. Source : pmu.fr.
La Figure 4 représente le nombre de paris par mois sans filtre d’espérance.
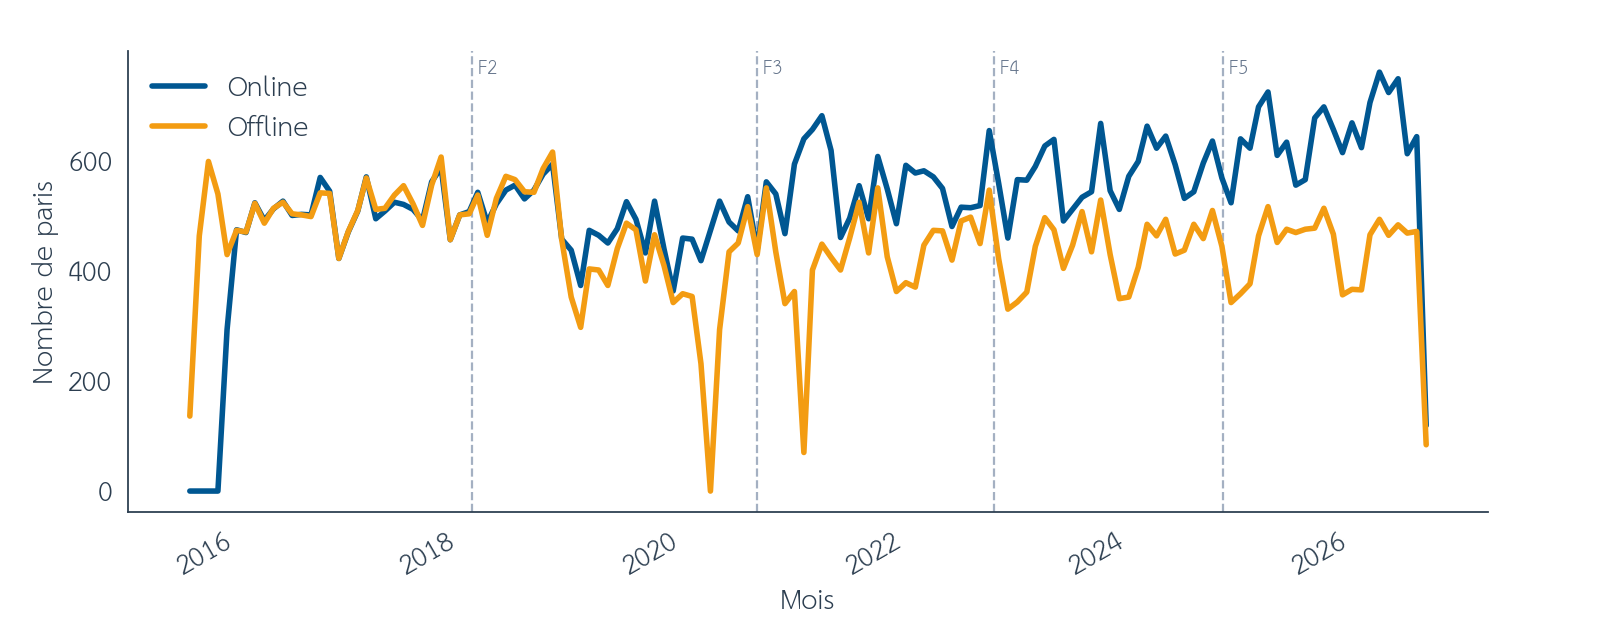
Figure 4 : Harville pur, nombre de paris par mois sans filtre d’espérance. Online / offline, entre août 2015 et septembre 2026. Les barres verticales en pointillés marquent les limites des folds walk-forward. Source : pmu.fr.
La Figure 5 présente le nombre de paris par mois avec \(EV_{\min} = 1\).
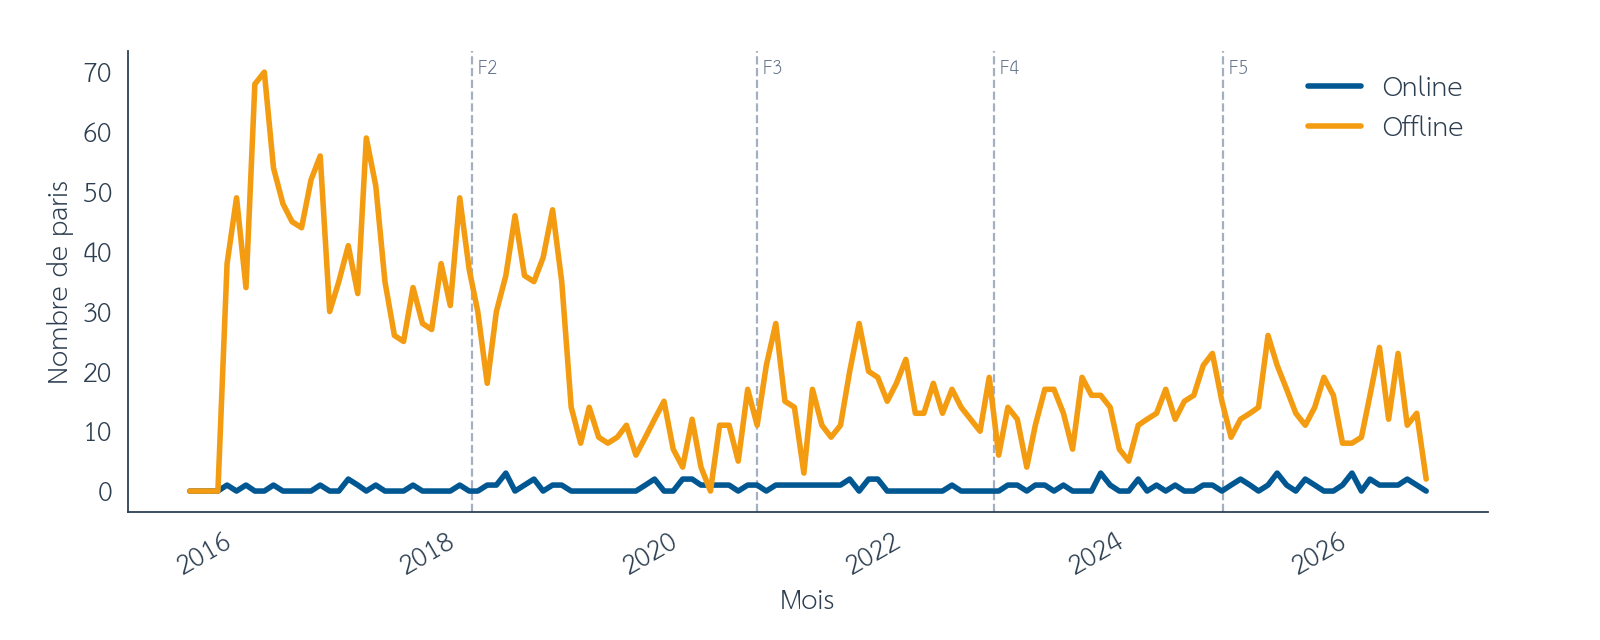
Figure 5 : Harville pur, nombre de paris par mois avec \(EV_{\min} = 1\). Online / offline, entre août 2015 et septembre 2026. Les barres verticales en pointillés marquent les limites des folds walk-forward. Source : pmu.fr.
Sans filtre (\(EV_{\min} = 0\)), le volume explose (~70 k tickets online, ~60 k offline) et le PnL cumulé plonge, avec un ROT ≈ −11,3 % online et −9,1 % offline. Avec \(EV_{\min} = 1\), le volume s’effondre (quelques dizaines de tickets online, ~2,7 k offline). L’online finit légèrement positif sur un échantillon trop mince pour conclure, et l’offline reste autour de −11 % de ROT. Ne pas filtrer multiplie les pertes en euros sans améliorer le rendement ; \(EV_{\min} = 1\) réduit surtout le turnover.
ii. Harville discounté
Même sélection « favori placé », mais reconstruction des cotes placé via le discount de Benter \(\gamma \approx 0{,}81\). Je garde \(EV_{\min} = 1\) pour isoler l’effet de \(\gamma\).
La Figure 6 montre le PnL cumulé Harville discounté (\(\gamma = 0{,}81\)), online et offline.
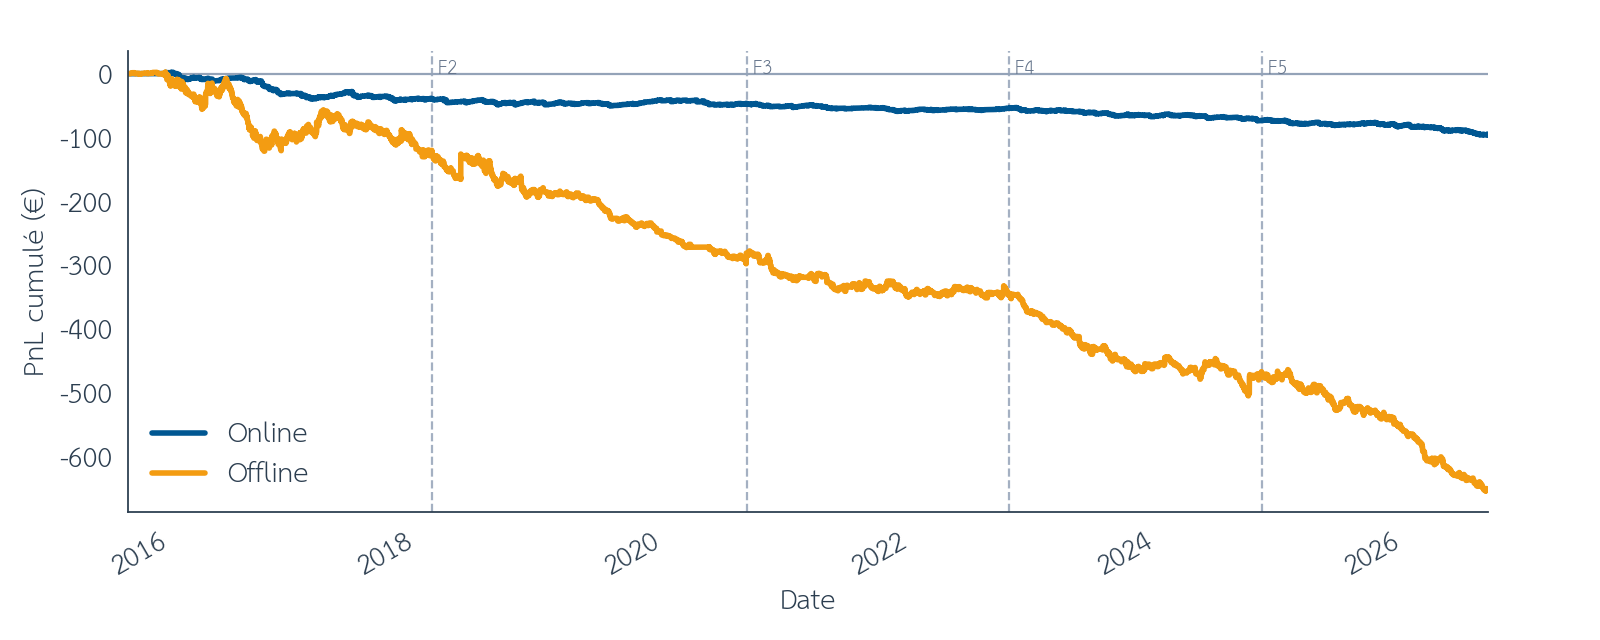
Figure 6 : Harville discounté (\(\gamma = 0{,}81\)), PnL cumulé, online et offline, entre août 2015 et septembre 2026. Les barres verticales en pointillés marquent les limites des folds walk-forward. Source : pmu.fr.
La Figure 7 présente le nombre de paris par mois pour cette même configuration.
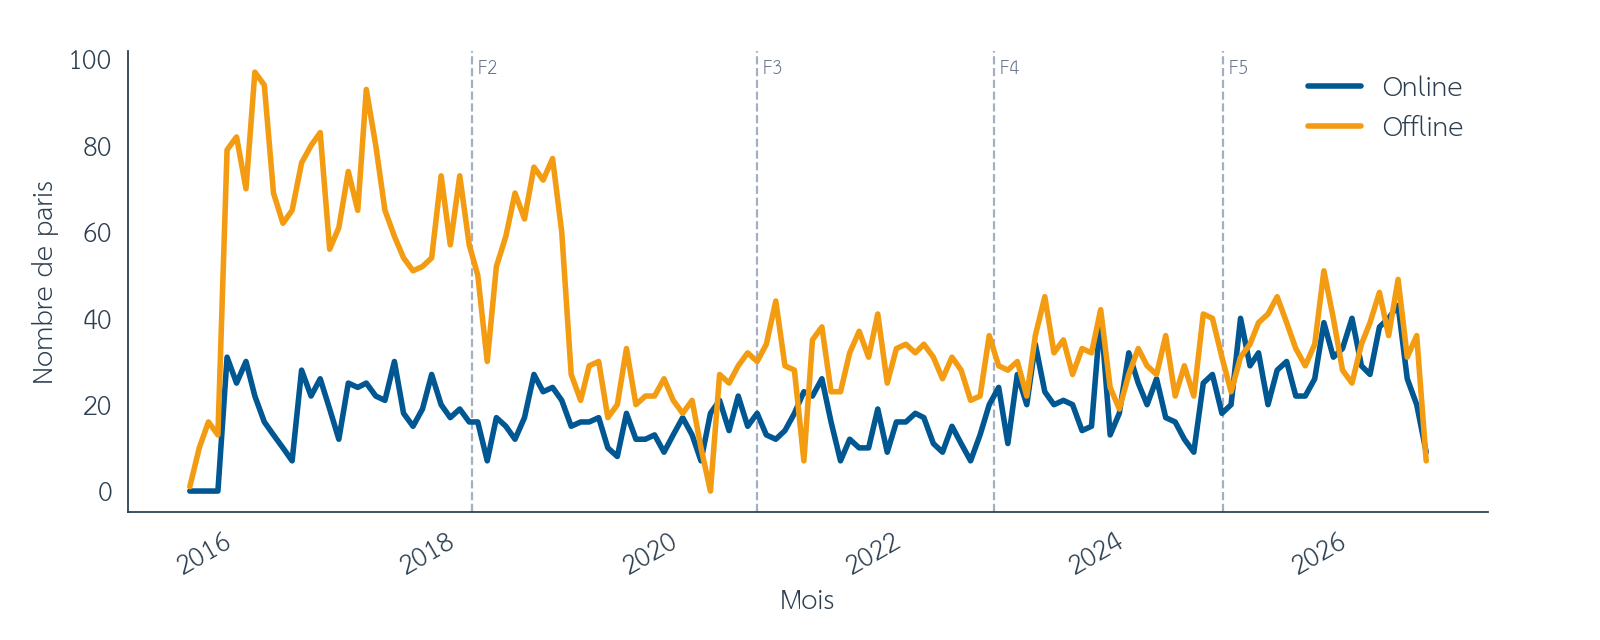
Figure 7 : Harville discounté (\(\gamma = 0{,}81\)), nombre de paris par mois, online / offline, entre août 2015 et septembre 2026. Les barres verticales en pointillés marquent les limites des folds walk-forward. Source : pmu.fr.
Le discount relève le volume par rapport au Harville pur filtré (plus de tickets passent \(EV_{\min}\)) et améliore le ROT online (~−3,1 %) comme offline (~−7,5 %) face au Harville pur à \(EV_{\min} = 1\) offline. Ce n’est toujours pas un edge « retail », mais \(\gamma\) n’est pas neutre. Il change à la fois la carte des cotes placé et le filtre d’espérance.
B. Bill Benter
Même univers et mêmes frictions que la baseline. Ce qui change, ce sont les probabilités fondamentales (logit / softmax) et l’agrégation marché \((\alpha,\beta)\), avec Harville discounté et sélection par edge. Mise plate pour la comparaison ; le critère de Kelly (formule (8)) reste le sizing de référence une fois l’edge établi.
Pour lire l’apport du fondamental, je superpose Bill Benter à la baseline Harville discounté (\(\gamma = 0{,}81\)), même estimateur de cotes placé, sans modèle fondamental.
La Figure 8 compare le PnL cumulé online de Bill Benter à la baseline Harville discounté, en mise plate.
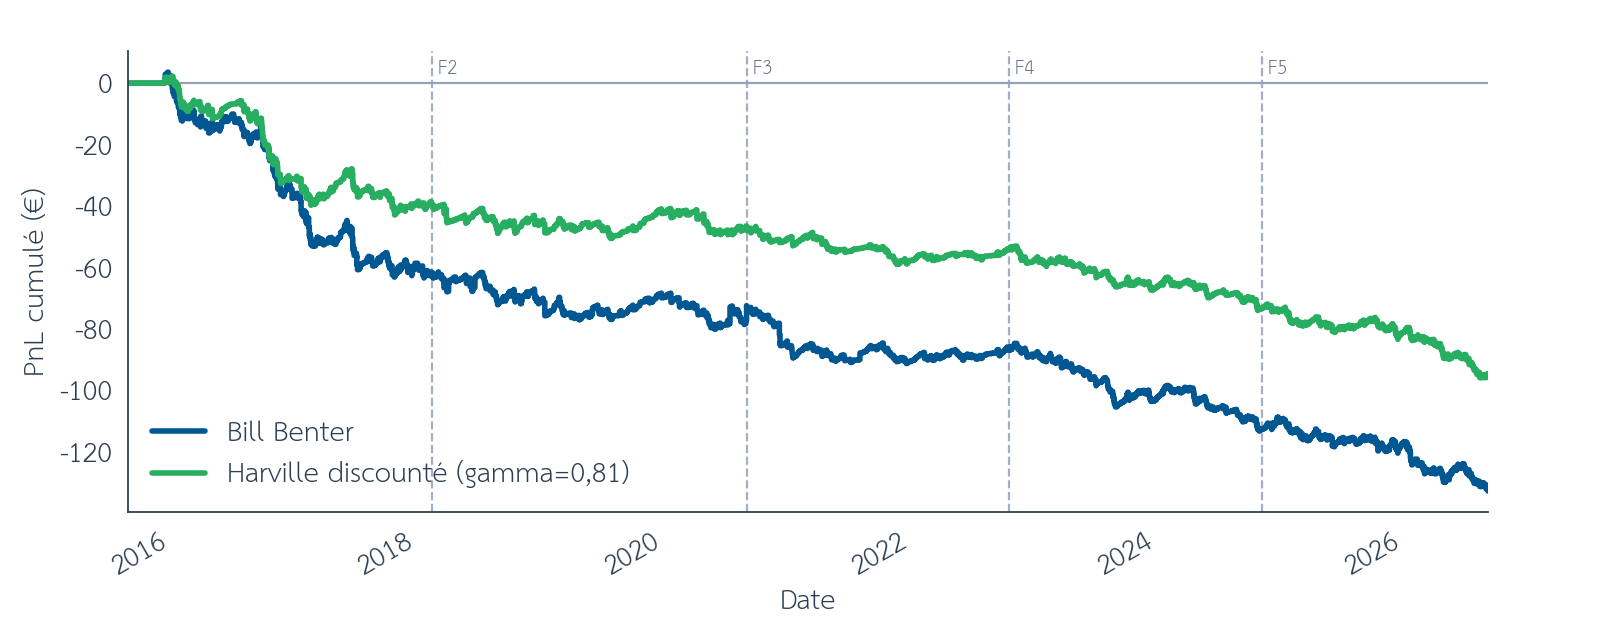
Figure 8 : Bill Benter vs baseline Harville discounté (\(\gamma = 0{,}81\)), PnL cumulé online, mise plate, entre août 2015 et septembre 2026. Les barres verticales en pointillés marquent les limites des folds walk-forward. Source : pmu.fr.
La Figure 9 montre le même PnL cumulé offline.
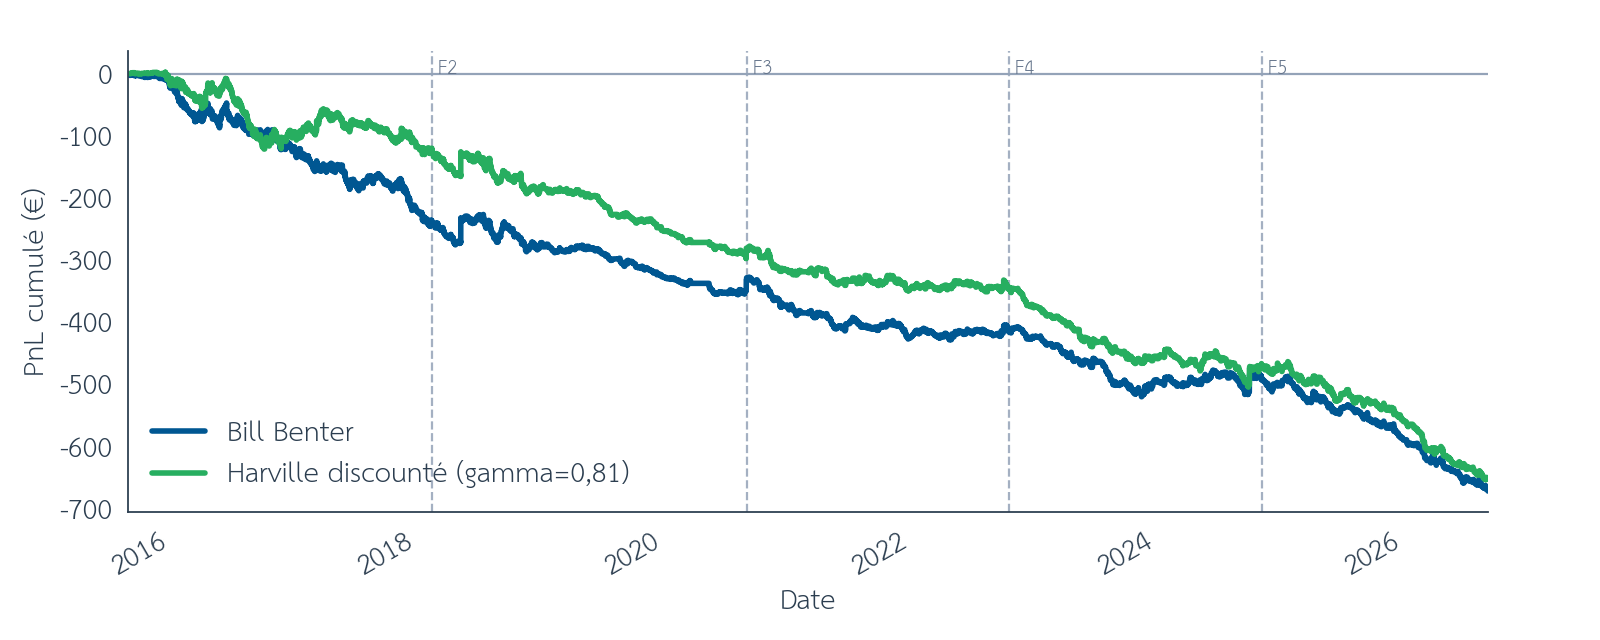
Figure 9 : Bill Benter vs baseline Harville discounté (\(\gamma = 0{,}81\)), PnL cumulé offline, mise plate, entre août 2015 et septembre 2026. Les barres verticales en pointillés marquent les limites des folds walk-forward. Source : pmu.fr.
La Figure 10 présente le nombre de paris par mois (online / offline) pour les deux approches.
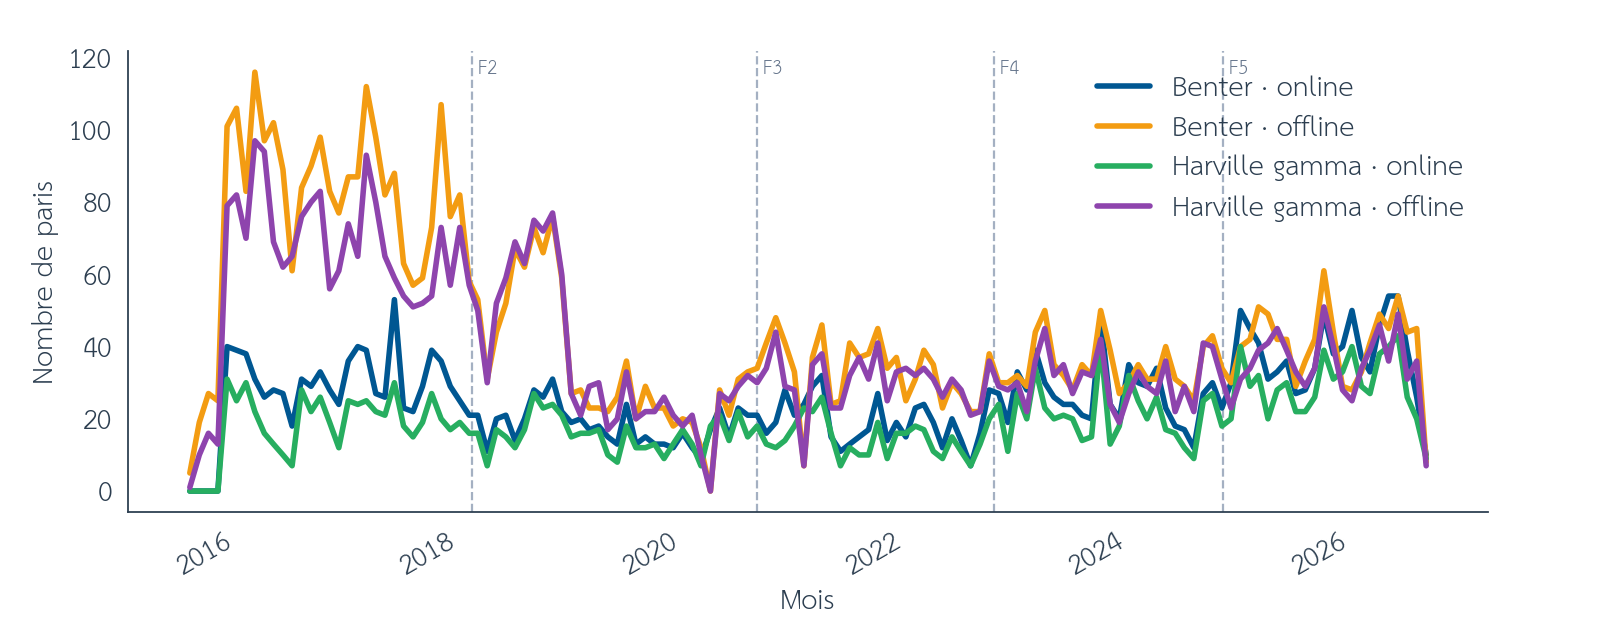
Figure 10 : Bill Benter vs Harville discounté, nombre de paris par mois (online / offline), entre août 2015 et septembre 2026. Les barres verticales en pointillés marquent les limites des folds walk-forward. Source : pmu.fr.
La version discountée offre de meilleures performances, en particulier en online (ROT autour de −3 % contre une baseline Harville pur beaucoup plus dégradée hors filtre). En revanche, le modèle de Bill Benter n’offre pas de surperformance claire par rapport au modèle naïf Harville discounté. Les courbes restent du même ordre. Cela prouve que la majorité de l’information exploitable est déjà incluse dans la cote.
C. LambdaRank
Même protocole que Bill Benter (plat, variables, walk-forward, \(EV_{\min}\), Harville discounté, agrégation \((\alpha,\beta)\)), mais l’estimateur fondamental n’est plus le logit multinomial. C’est un LambdaRank entraîné avec LightGBM, en learning-to-rank par course (sur le classement d’arrivée).
L’idée est de garder la « coquille » Benter (marché + discount + filtre d’espérance) et de ne changer que le cœur qui produit les scores fondamentaux, pour isoler l’effet de l’algo de ranking.
La Figure 11 montre le PnL cumulé online de Bill Benter face à LambdaRank (LightGBM), en mise plate.
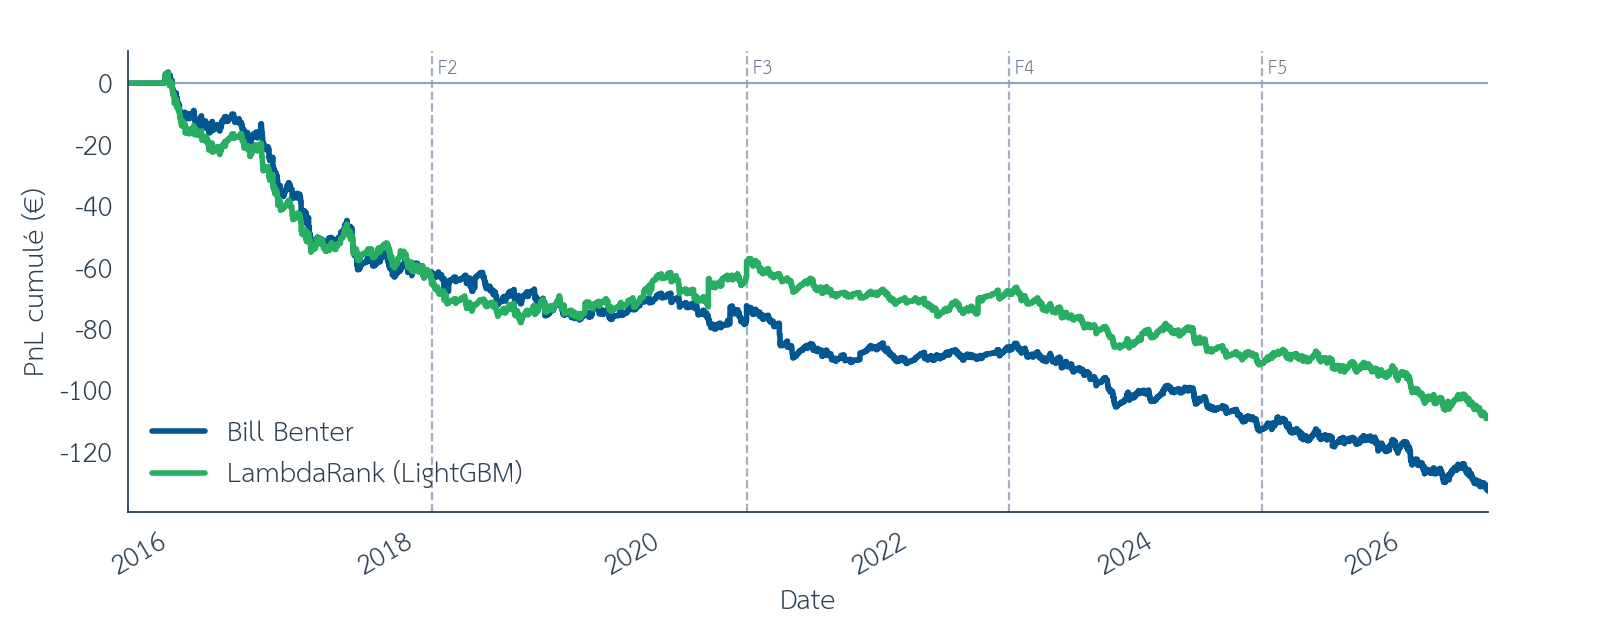
Figure 11 : Bill Benter vs LambdaRank (LightGBM), PnL cumulé online, mise plate, entre août 2015 et septembre 2026. Les barres verticales en pointillés marquent les limites des folds walk-forward. Source : pmu.fr.
La Figure 12 montre le même PnL cumulé offline.
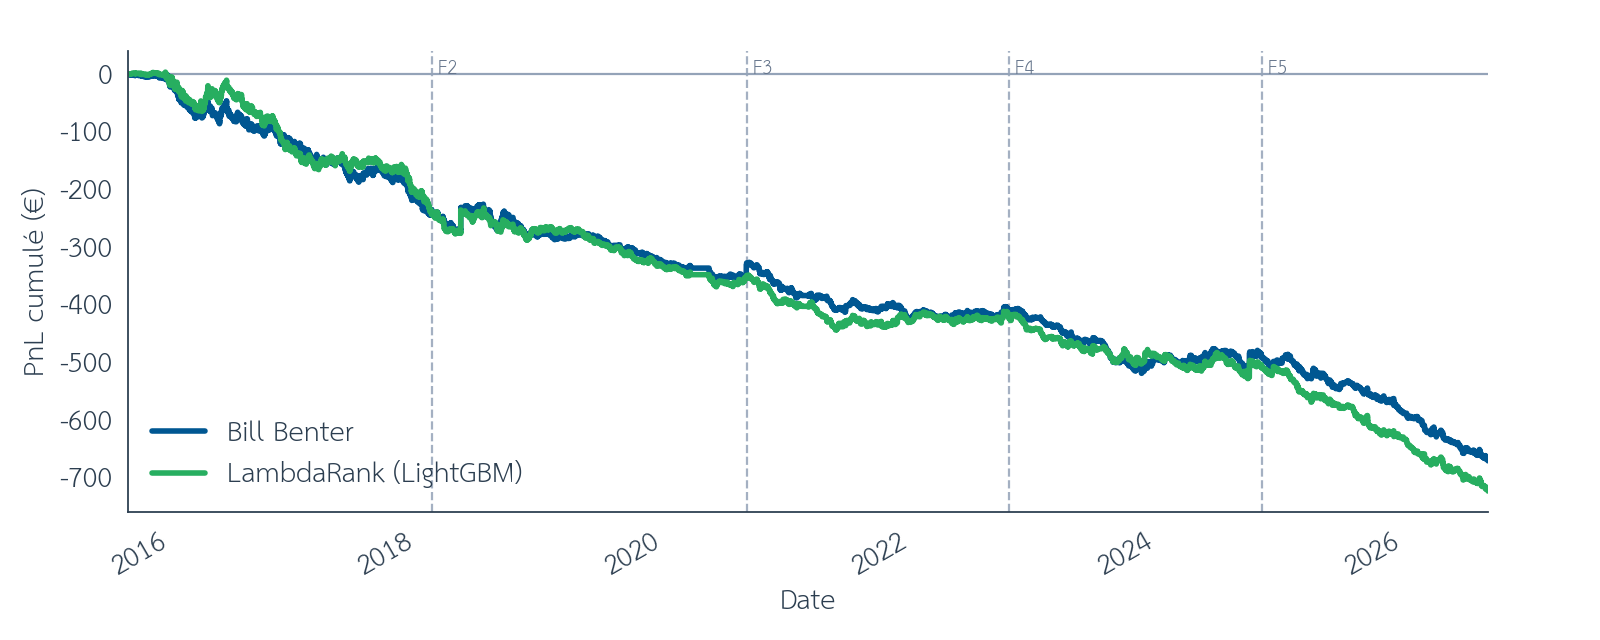
Figure 12 : Bill Benter vs LambdaRank, PnL cumulé offline, mise plate, entre août 2015 et septembre 2026. Les barres verticales en pointillés marquent les limites des folds walk-forward. Source : pmu.fr.
La Figure 13 présente le nombre de paris par mois (online / offline) pour les deux modèles.
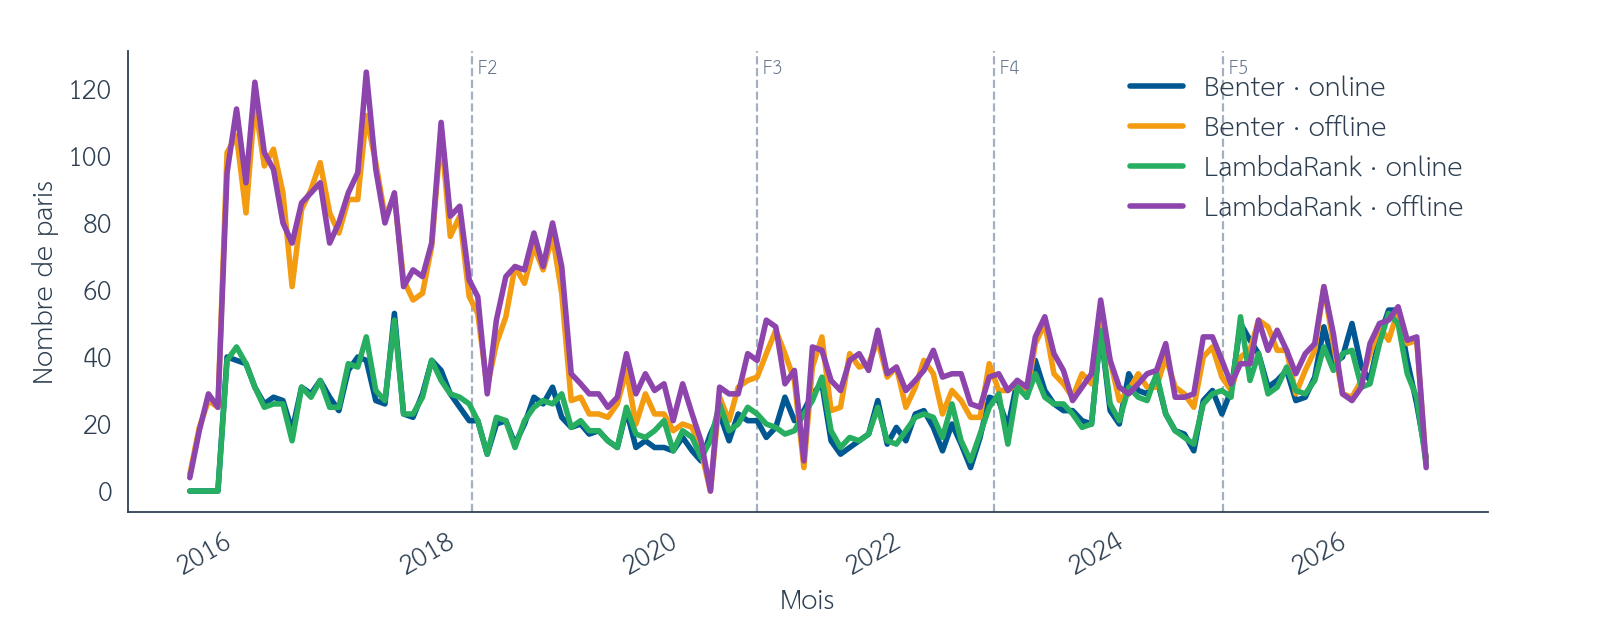
Figure 13 : Bill Benter vs LambdaRank, nombre de paris par mois (online / offline), entre août 2015 et septembre 2026. Les barres verticales en pointillés marquent les limites des folds walk-forward. Source : pmu.fr.
Sur cet univers, les deux modèles restent négatifs après rake. Sur les données online, LambdaRank fait un peu mieux que Benter (ROT ≈ −2,7 % vs −3,3 %) ; offline, les deux restent autour de −7 %. Le ranking GBM ne bascule pas le signe du PnL.
D. Synthèse
Le Tableau 7 regroupe les métriques Simple Placé (mise plate, walk-forward). Je note \(EV_{\min}\) le seuil d’espérance utilisé pour filtrer les tickets. Je ne mise que si \(\hat{p} \times \text{cote} \ge EV_{\min}\). Ainsi, \(EV_{\min} = 0\) correspond à l’absence de filtre, et \(EV_{\min} = 1\) au seuil d’équilibre (espérance nulle avant rake).
| Métrique | Harville \(EV_{\min}{=}0\) | Harville \(EV_{\min}{=}1\) | Harville \(\gamma{=}0{,}81\) | Benter | LambdaRank | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Online | Offline | Online | Offline | Online | Offline | Online | Offline | Online | Offline | |
| ROT | −11,3 % | −9,1 % | +4,6 %* | −11,0 % | −3,1 % | −7,5 % | −3,3 % | −6,8 % | −2,7 % | −7,0 % |
| PnL cumulé | −9 646 € | −9 011 € | +4,8 €* | −482 € | −96 € | −653 € | −133 € | −672 € | −109 € | −724 € |
| Volume misé | 85 340 € | 98 916 € | 104 €* | 4 392 € | 3 106 € | 8 654 € | 4 078 € | 9 856 € | 4 096 € | 10 411 € |
| Nombre de tickets | 70 719 | 59 785 | 87* | 2 730 | 2 578 | 5 304 | 3 370 | 6 043 | 3 364 | 6 392 |
Tableau 7 : Synthèse Simple Placé, baselines Harville, Bill Benter, LambdaRank (online / offline). (*) Échantillon online très mince sous \(EV_{\min} = 1\) (Harville pur). Les signes « + » ne sont pas interprétables hors de ce volume.
La comparaison utile n’est pas « modèle vs hasard », c’est modèle vs baseline à rake, canaux et horizon égaux. Sans \(EV_{\min}\), la baseline détruit du capital à grande échelle ; avec \(EV_{\min} = 1\), elle mise peu. Le discount \(\gamma\) et les modèles (Benter, LambdaRank) améliorent le ROT relatif, mais restent sous l’eau après rake. Ici, la Partie 3 change d’angle.
E. Analyse
L’objectif de cette section est de comparer les performances obtenues selon les différences caractéristiques de la course, afin de voir si certaines configurations sont plus propices aux gains que d’autres. Les graphes de segmentation métier (Simple Placé) superposent les ROI des modèles. Le ROI est mesuré en agrégeant les canaux online et offline (profit et volume misé cumulés sur les deux bassins). Le chiffre au-dessus de chaque barre est le nombre d’échantillons (tickets) ayant servi à construire la barre. Je ne retiens ici que les graphiques les plus significatifs, ceux qui concentrent l’essentiel de la variabilité du ROI sur le plat.
La Figure 14 montre le ROI Simple Placé (online et offline agrégés) selon les quintiles de confiance du modèle. En tendance, les ROI les plus mauvais sont aux confiances basses, et le ROI s’améliore quand la confiance monte (chez Benter et la baseline \(\gamma\) ; la baseline Harville pure rechute en Q5).
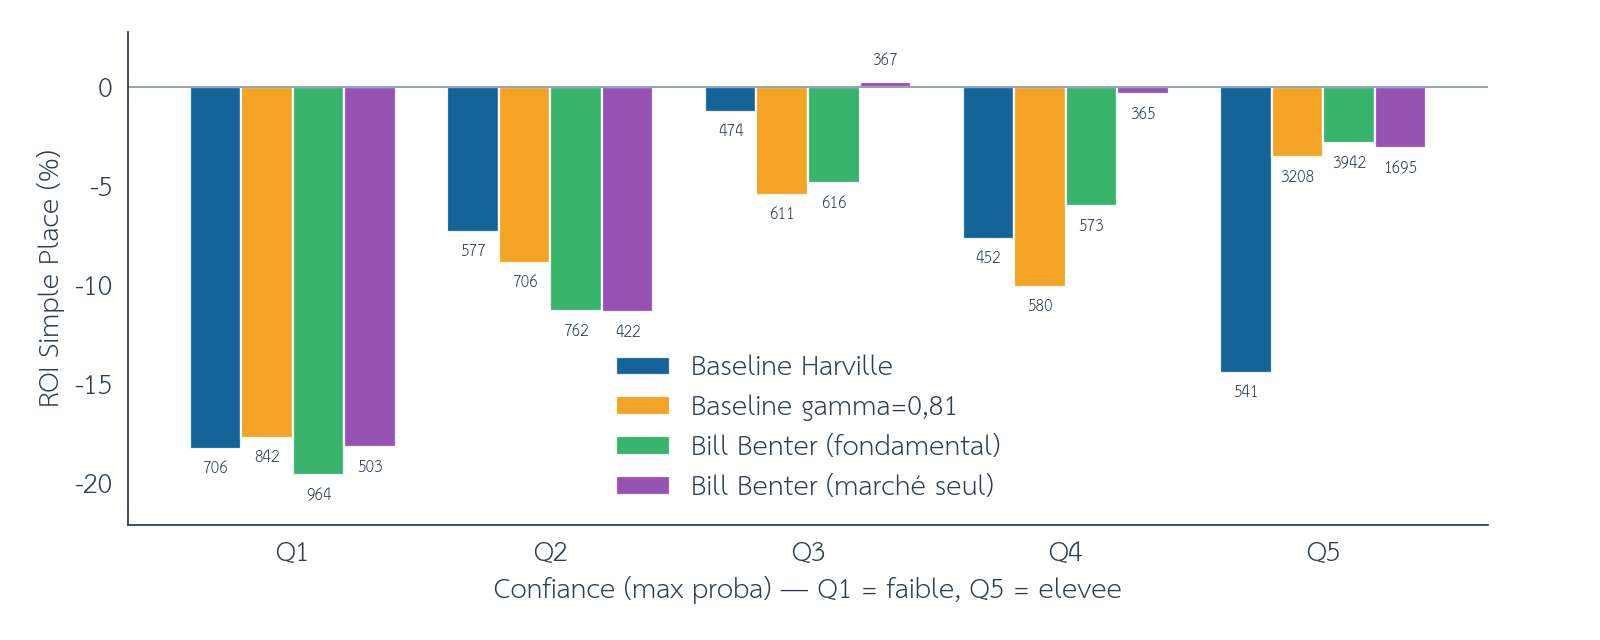
Figure 14 : ROI Simple Placé selon les quintiles de confiance du modèle (Q1 = faible → Q5 = élevée), online et offline agrégés. Le nombre au-dessus de chaque barre est l’effectif, entre août 2015 et septembre 2026. Source : pmu.fr.
Comme présenté dans la Figure 15, le ROI Simple Placé (online et offline agrégés) varie aussi selon les quartiles d’enjeux Simple Gagnant. Plus le montant des enjeux est faible, plus le ROI monte.
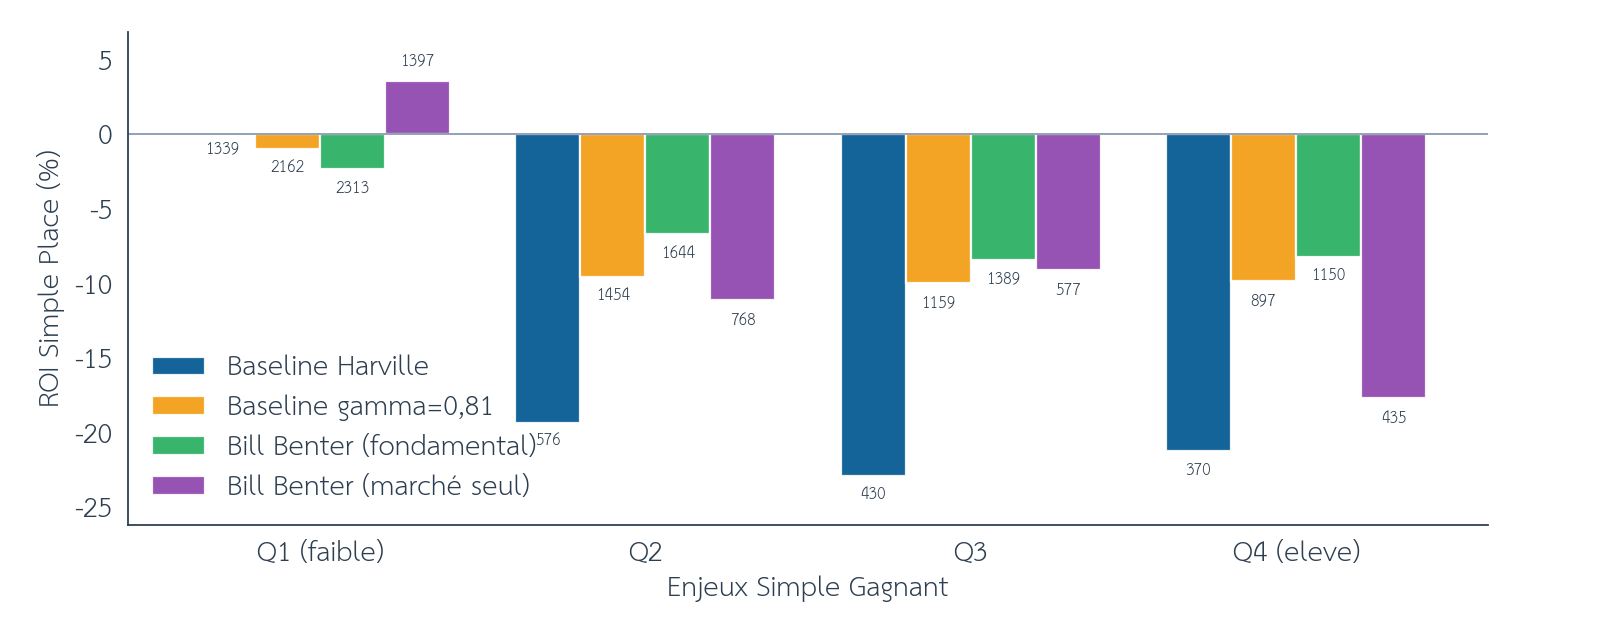
Figure 15 : ROI Simple Placé selon les quartiles d’enjeux Simple Gagnant, online et offline agrégés. Effectifs au-dessus des barres, entre août 2015 et septembre 2026. Source : pmu.fr.
La Figure 16 présente enfin le ROI Simple Placé (online et offline agrégés) selon le nombre de partants. Plus le nombre de partants est élevé, plus le ROI est faible. C’est cohérent. Un peloton plus large introduit davantage d’aléatoire. De plus, en course de plat, un très bon cheval peut se retrouver coincé dans la mêlée et ne jamais pouvoir sortir dans la dernière ligne droite, faute de passage, parce que trop de chevaux l’encerclent.
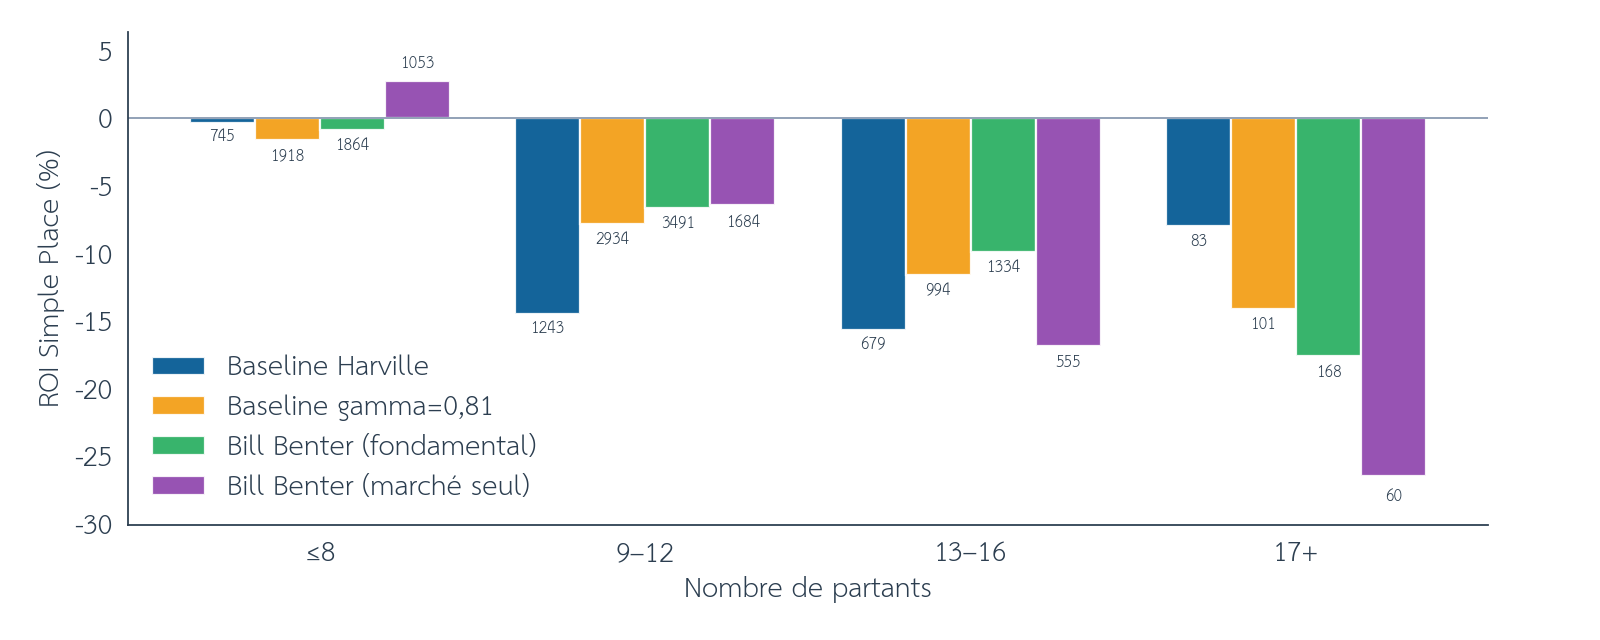
Figure 16 : ROI Simple Placé selon le nombre de partants (≤8, 9, 12, 13, 16, 17+), online et offline agrégés. Effectifs au-dessus des barres, entre août 2015 et septembre 2026. Source : pmu.fr.
Le constat est le même pour tous les modèles, y compris les baselines et Bill Benter. À partir de cette analyse, le modèle de Bill Benter n’est pas si mauvais. Au contraire, il arrive dans certaines situations à générer un ROI > 0 selon la confiance, le nombre de partants et le montant des enjeux. Souvent, lorsque l’effectif est faible, les performances deviennent positives, signe de niches (régimes rares) plutôt que d’un edge robuste sur tout l’univers. En particulier, les courses à faible enjeux, plus sujettes au bruit récréatif et souvent moins liquides donc davantage délaissées, sont celles où Bill Benter affiche les meilleures performances. Cela confirme l’hypothèse évoquée en Partie 1, section 3.C (Late money, niches et bruit de la foule).
Ces trois axes, confiance, enjeux et nombre de partants, concentrent l’essentiel de la variabilité du ROI observée sur le plat. C’est ce trio que la Partie 3 reprendra.
5. Conclusion
La lecture d’ensemble est claire. Au global, après rake, la baseline, Bill Benter et LambdaRank restent sous l’eau. Le discount \(\gamma\) et les modèles améliorent le ROT relatif par rapport à une baseline non filtrée, mais ils ne basculent pas le signe du PnL sur tout l’univers. En revanche, la segmentation de la section 4.E montre des niches où le ROI peut devenir positif, surtout lorsque la confiance est plus élevée, les enjeux plus faibles ou l’effectif plus réduit. Ce n’est pas encore un edge robuste et scalable. C’est un signal de structure.
La Partie 3 change donc d’angle. Il s’agit moins de « mieux prédire le classement » que d’exploiter la structure des courses, en faisant varier la discipline et en se focalisant sur les trois critères les plus déterminants pour la variabilité du ROI. Ces critères sont les enjeux, la confiance et le nombre de partants.